
Nicht jeder Website-Besucher ist ein Mensch. Aber nicht jeder Bot ist ein Problem.
Sie investieren in SEO, Google Ads und Content Marketing. Ihr Analytics-Dashboard zeigt Besucher, Sitzungen und Seitenaufrufe. Doch wer greift tatsächlich auf Ihre Website zu? Neben potenziellen Kunden sind es automatisierte Systeme, die Inhalte lesen, auswerten und für KI-Anwendungen bereitstellen.
Der AI-Traffic-Benchmarkbericht 2026 von Leadinfo liefert dazu bemerkenswerte Zahlen: Im dritten Quartal 2026 sollen 12,6 % der untersuchten Traffic-Events auf nicht-menschliche Zugriffe entfallen sein. Der ausgewiesene Anteil von KI-Agenten stieg von 0,1 % in Q1 auf 5,32 % in Q3. Die Analyse basiert laut Leadinfo auf rund neun Milliarden Events aus dem eigenen B2B-Kundenbestand.
Die Zahlen zeigen eine mögliche Verschiebung, werfen aber auch Fragen auf: Wie wurden KI-Agenten erkannt? Welche Zugriffe sind für das Marketing relevant? Und wie können Unternehmen diese Entwicklung mit ihren vorhandenen Tools überprüfen?
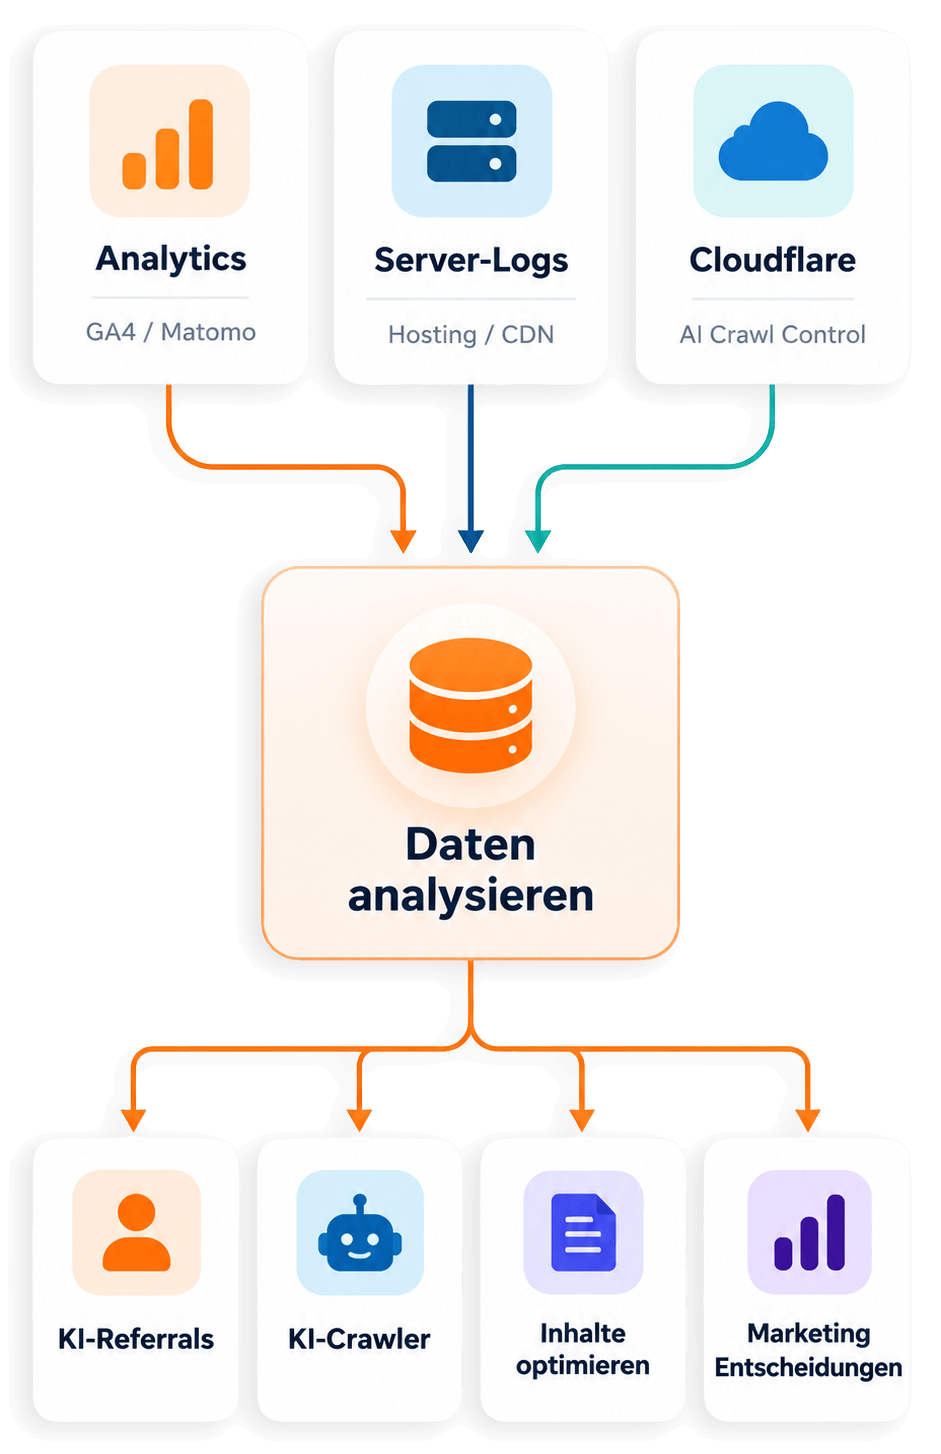
Für erste Antworten brauchen Sie weder eine neue Analytics-Plattform noch ein großes KI-Projekt. Entscheidend ist, die richtigen Datenquellen zu nutzen und unterschiedliche Arten von KI-Traffic nicht zu verwechseln.
Kurz zusammengefasst
- KI-Traffic ist nicht gleich Bot-Traffic: Menschen, die aus ChatGPT auf Ihre Website gelangen, sind anders zu bewerten als automatisierte Crawler.
- GA4 und Matomo zeigen einen Teil des Bildes: Weiterleitungen aus KI-Systemen lassen sich messen. Für automatisierte Abrufe benötigen Sie weitere Daten.
- Server-Logs und Cloudflare helfen bei der Einordnung: Bekannte KI-Crawler können über User-Agents und weitere technische Merkmale erkannt werden.
- Ein Crawler-Besuch ist kein Lead: Häufige Abrufe beweisen weder Kaufinteresse noch eine Nennung in einer KI-Antwort.
- Aus Daten sollten Maßnahmen werden: Prüfen Sie Inhalte, Erreichbarkeit und vor allem qualifizierte Anfragen.
Was ist KI-Traffic – und warum ist die Unterscheidung wichtig?
Stellen Sie sich zwei Situationen vor: Eine Einkäuferin recherchiert mit ChatGPT nach einem Maschinenbau-Zulieferer, klickt auf einen vorgeschlagenen Anbieter, informiert sich auf dessen Website und stellt eine Anfrage. Ein echter Website-Besuch ist entstanden.
Im zweiten Fall ruft ein automatisierter KI-Crawler eine Produktseite ab und liest ihre technischen Spezifikationen. Ein menschlicher Website-Besuch findet dabei nicht statt. Beide Vorgänge werden häufig als „KI-Traffic“ bezeichnet. Für Ihre Marketingentscheidungen bedeuten sie jedoch völlig Unterschiedliches.
- Menschen aus KI-Anwendungen: Sie folgen einem Link aus etwa ChatGPT oder Perplexity. Diese Sitzungen können Anfragen und Umsatz erzeugen.
- KI-Suchcrawler: Systeme wie OAI-SearchBot oder PerplexityBot erfassen Inhalte für Such- und Antwortfunktionen. Der Abruf belegt keine spätere Empfehlung.
- Nutzerinitiierte KI-Abrufe: Ein Assistent ruft im Zusammenhang mit einer Anfrage eine Seite ab, beispielsweise mit ChatGPT-User oder Claude-User. Die Identität und Kaufabsicht des Menschen bleiben daraus unbekannt.
- Training-Crawler und sonstige Bots: Manche Systeme sammeln Trainingsdaten, andere prüfen oder überwachen Websites. Sie sind nicht pauschal als Marketing-Erfolg oder als verlorenes Werbebudget einzustufen.
Die wichtigste Regel: Ein KI-Request ist kein Lead. Und ein KI-Crawler ist nicht automatisch ein bezahlter Anzeigenklick.
Wie erkennen Sie ChatGPT, Gemini, Claude und andere KI-Systeme?
Viele Anbieter kennzeichnen ihre automatisierten Abrufe mit einem User-Agent. Das ist eine technische Kennung, die ein Programm beim Zugriff auf den Webserver übermitteln kann. Die folgende Übersicht bietet einen Einstieg in die Analyse:
| Anbieter | Kennung / User-Agent | Typische Funktion |
|---|---|---|
| OpenAI | OAI-SearchBot |
ChatGPT Search |
| OpenAI | ChatGPT-User |
Abrufe im Zusammenhang mit Nutzeraktionen |
| OpenAI | GPTBot |
Potentielles Modelltraining |
| Anthropic | Claude-SearchBot |
KI-Suche |
| Anthropic | Claude-User |
Nutzerinitiierte Abrufe |
| Anthropic | ClaudeBot |
Training-Crawler |
| Perplexity | PerplexityBot |
KI-Suche |
| Perplexity | Perplexity-User |
Nutzerinitiierte Abrufe |
Googlebot |
Google-Suchindex; kein eindeutiger Gemini-Nachweis | |
GoogleOther |
Weitere Google-Abrufe; kein eindeutiger Gemini-Nachweis | |
| Meta | meta-externalagent |
Automatisierte Inhaltsabrufe |
| Meta | meta-externalfetcher |
Nutzerinitiierte Abrufe |
Besonderheit Google: Google-Extended ist kein separater HTTP-User-Agent, sondern ein Steuertoken für die robots.txt. Aus einem Googlebot-Besuch folgt nicht, dass Ihre Website in einer Gemini-Antwort verwendet wurde.
Wichtig: User-Agents lassen sich technisch nachahmen. Für eine belastbare Auswertung sollten Sie Kennungen – soweit möglich – über veröffentlichte IP-Bereiche, DNS-Verifizierung oder vertrauenswürdige Bot-Management-Systeme prüfen. Auch damit werden nicht sämtliche KI-Zugriffe sichtbar.
Offizielle Referenzen: OpenAI-Crawler, Anthropic-Crawler, Google-Crawler, Cloudflare-Bot-Verzeichnis.
Schritt 1: Besucher aus KI-Systemen mit GA4 oder Matomo messen
Beginnen Sie mit der einfachsten Frage: Wie viele Menschen gelangen über KI-Anwendungen auf Ihre Website?
Öffnen Sie die Berichte zur Traffic-Akquisition und suchen Sie nach verweisenden Quellen wie chatgpt.com, perplexity.ai oder claude.ai. In Google Analytics 4 eignet sich beispielsweise die Dimension „Sitzungsquelle/-medium“, in Matomo die Auswertung verweisender Websites.
Erstellen Sie nach Möglichkeit eine eigene Kanalgruppe für erkennbare KI-Weiterleitungen und prüfen Sie:
- Wie viele Sitzungen kommen aus welchen KI-Anwendungen?
- Welche Seiten werden zuerst besucht?
- Wie viele Kontaktanfragen oder andere relevante Conversions entstehen?
- Wie viele dieser Anfragen werden im CRM zu qualifizierten Leads?
Grenze der Messung: Nicht jeder Besuch nach einer KI-Recherche hat einen erkennbaren Referrer. Menschen können Empfehlungen kopieren oder eine Website später direkt aufrufen. Und einzelne Gemini-Nutzungen lassen sich nicht verlässlich von allen anderen Google-Zugriffen trennen. AI-Referral-Traffic zeigt daher nur den messbaren Teil des KI-Einflusses.
Schritt 2: KI-Crawler über Server-Logs identifizieren
Google Analytics 4 schließt bekannte Bots und Spider automatisch aus. Wie viele Ereignisse dabei entfernt wurden, zeigt GA4 nicht an. Für die Analyse automatisierter Zugriffe benötigen Sie deshalb ergänzende Informationen – beispielsweise aus den HTTP-Access-Logs Ihres Webservers.
Ein Server-Log kann unter anderem Datum, Uhrzeit, aufgerufene URL, User-Agent, IP-Adresse und HTTP-Statuscode enthalten. Viele Hosting-Anbieter stellen solche Protokolle über ihre Verwaltung bereit.
- Logs abrufen: Fragen Sie Ihren Hoster nach den HTTP-Zugriffsprotokollen eines geeigneten Zeitraums, beispielsweise der letzten 30 Tage.
- Felder prüfen: Sind URL, Zeitpunkt, User-Agent und Statuscode enthalten?
- Nach Kennungen suchen: Filtern Sie beispielsweise auf
OAI-SearchBot,ClaudeBotundPerplexityBot. - Treffer verifizieren: Nutzen Sie nach Möglichkeit dokumentierte IP-Bereiche oder andere Prüfverfahren.
- Nach Seiten auswerten: Wie viele Requests entfallen auf welche Betreiber und welche URLs?
Achtung bei der Interpretation: Ein HTTP-Request ist keine Analytics-Sitzung. Auch mehrere Requests können zu einem Seitenabruf gehören. Läuft Ihre Website hinter einer CDN- oder Sicherheitslösung, sieht der eigentliche Webserver womöglich nicht alle blockierten Anfragen.
Datenschutzhinweis: IP-Adressen können personenbezogene Daten sein. Prüfen Sie bei Log-Analysen Zweck, Rechtsgrundlage, Zugriffsschutz und Aufbewahrungsdauer.
Google erklärt den automatischen Ausschluss bekannter Bots in Analytics.
Schritt 3: KI-Traffic mit Cloudflare analysieren
Wenn Ihre Website über Cloudflare läuft und der Traffic entsprechend über den Dienst geleitet wird, können Sie AI Crawl Control verwenden. Die Funktion zeigt erkannte KI-Crawler und ermöglicht Auswertungen unter anderem nach Betreibern, Request-Mengen, URL-Pfaden und Antwortcodes.
- Öffnen Sie das Cloudflare-Dashboard für Ihre Domain.
- Wechseln Sie zu „AI Crawl Control“.
- Prüfen Sie Übersicht und Crawler-Liste.
- Vergleichen Sie Request-Mengen, häufig abgerufene Seiten und Fehlercodes.
- Entscheiden Sie erst nach der Auswertung, ob bestimmte Crawler zugelassen oder eingeschränkt werden sollen.
Die Tiefe der Analyse hängt vom Tarif ab. Im kostenlosen Tarif basiert die Erkennung bekannter KI-Crawler in erster Linie auf User-Agents; der Analysezeitraum ist begrenzt. Cloudflare ist damit ein praktischer Einstieg, aber keine Garantie für die vollständige Erkennung aller KI-Agenten und kein Messinstrument für tatsächliche Erwähnungen in KI-Antworten.
Was verrät Ihnen das Verhalten von KI-Crawlern wirklich?
Die bloße Zahl der Requests ist selten die wichtigste Erkenntnis. Interessant wird es, wenn Sie verstehen, welche Seiten ein System abruft, ob diese erreichbar sind und was sich daraus für Ihr Marketing ableiten lässt.
- Viele KI-Requests auf Produktseiten: Prüfen Sie, ob Einsatzbereiche, technische Daten, Produktvorteile und Unterschiede verständlich beschrieben sind.
- Viele 403- oder 404-Antworten: Überprüfen Sie Zugriffsregeln, Weiterleitungen und die Erreichbarkeit wichtiger Inhalte.
- Qualifizierte Leads aus AI Referrals: Vergleichen Sie Landingpages, Themen und Conversion-Angebote. Welche Inhalte führen zu echten Gesprächen?
- Viele KI-Requests, aber kaum AI Referrals: Das ist kein automatisches Problem. Untersuchen Sie separat, ob Ihre Marke bei relevanten Fragen in KI-Systemen tatsächlich genannt wird.
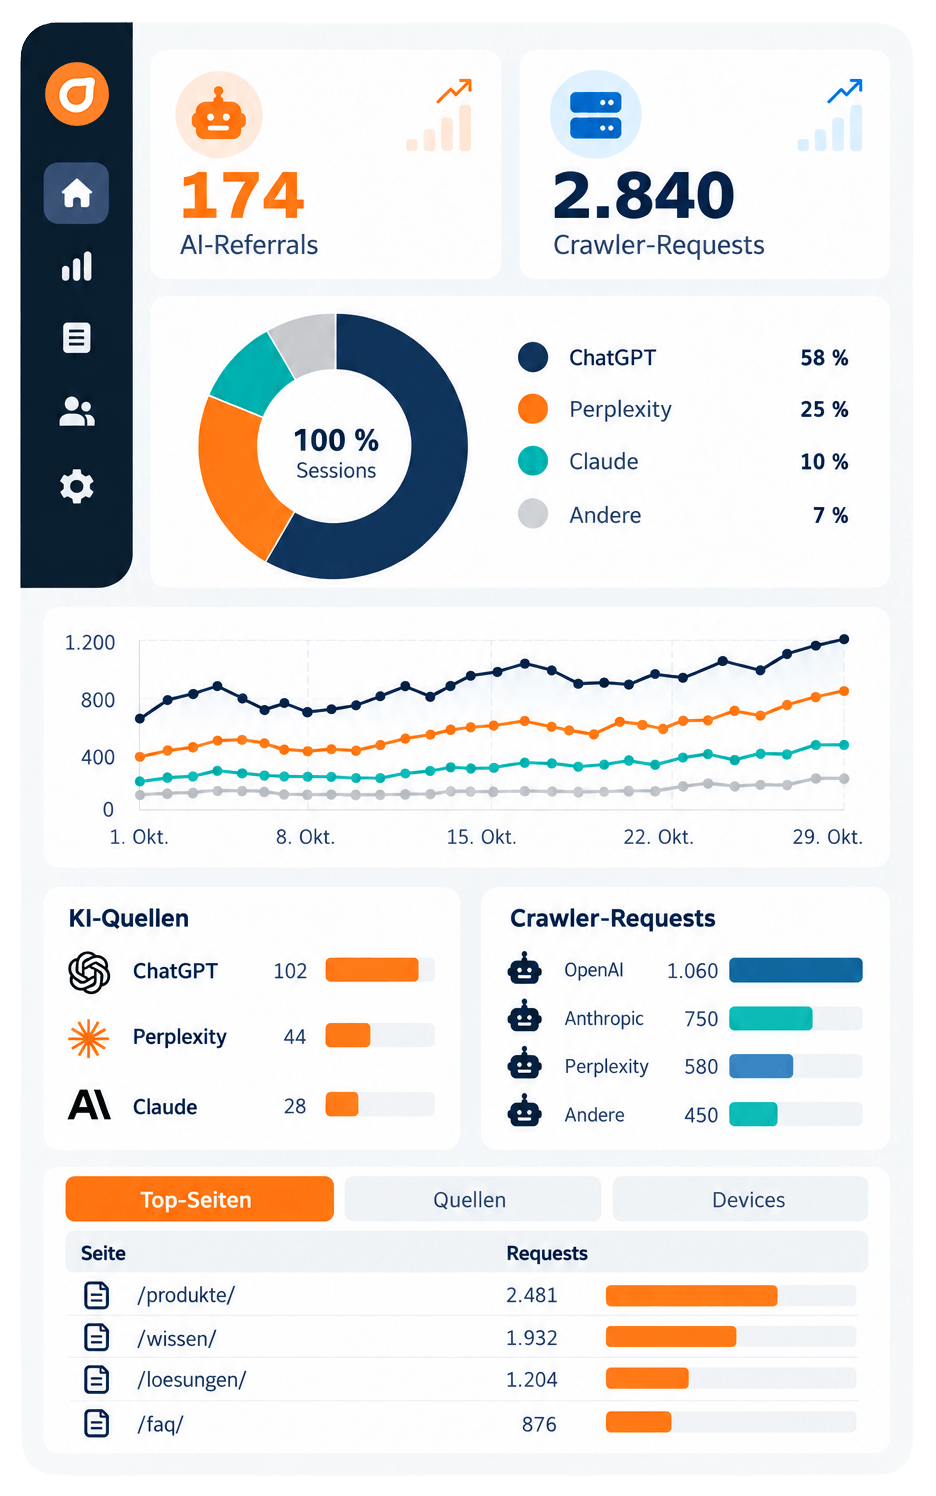
KI-Crawling, KI-Sichtbarkeit und KI-generierte Leads sind unterschiedliche Kennzahlen. Häufige Abrufe belegen keine spätere Empfehlung oder Kaufabsicht.
Verursacht KI-Traffic höhere Werbekosten?
Der Leadinfo-Benchmarkbericht warnt davor, dass KI-Agenten Marketingkennzahlen verzerren und Werbebudget in nicht kaufende Zugriffe fließen kann. Diesen Hinweis sollten Unternehmen ernst nehmen – aber differenziert betrachten.
Ein Crawler-Request bedeutet nicht automatisch, dass dafür ein bezahlter Anzeigenklick angefallen ist. Google Ads und andere Werbeplattformen setzen Verfahren ein, um ungültige Zugriffe zu erkennen und herauszufiltern. Auch der Cost-per-Lead steigt nicht schon deshalb, weil mehr Bots in einem Server-Log auftauchen: Üblicherweise berechnet er sich aus Werbekosten geteilt durch gewonnene Leads.
Problematisch wird es, wenn Kampagnen anhand ungeeigneter oder fehlerhafter Signale optimiert werden. Deshalb sollten Marketing- und Vertriebsteams einen gemeinsamen Blick auf die gesamte Kette werfen:
Anzeigenklick → Website-Besuch → Lead → qualifizierter Lead → Opportunity → Kunde
Je besser Analytics, CRM und Werbedaten zusammenspielen, desto nachvollziehbarer ist der tatsächliche Geschäftserfolg. Google Ads erläutert die Erkennung ungültiger Zugriffe einschließlich technischer Bots.
Ihr KI-Traffic-Check: Fünf Maßnahmen für den Einstieg
Sie müssen nicht sofort sämtliche Datenquellen miteinander verbinden. Für eine erste Bestandsaufnahme reicht ein überschaubares Vorgehen:
- AI Referrals sichtbar machen: Prüfen Sie in GA4 oder Matomo erkennbare Sitzungen aus ChatGPT, Perplexity und anderen Quellen.
- Server-Logs verfügbar machen: Klären Sie mit Ihrem Hosting-Anbieter, welche HTTP-Zugriffsprotokolle vorliegen.
- Bekannte KI-Crawler erkennen: Klassifizieren Sie User-Agents und prüfen Sie die Identität der Bots soweit möglich.
- Inhalte und technische Auffälligkeiten bewerten: Welche Seiten werden abgerufen? Gibt es Fehlermeldungen oder unerwünschte Sperren?
- Geschäftsergebnisse zuordnen: Verknüpfen Sie die erkennbaren Besucherquellen mit Anfragen und möglichst CRM-Daten.
Für viele mittelständische Websites genügt zunächst eine monatliche Auswertung. Wenn Umfang und Erkenntnisgewinn steigen, kann daraus ein automatisiertes Monitoring entstehen – idealerweise mit Ihren vorhandenen Werkzeugen.

Wissen Sie, wer Ihre Website wirklich besucht?
Wir helfen Ihnen, KI-Traffic aus bestehenden Datenquellen zu erkennen, korrekt einzuordnen und daraus konkrete Maßnahmen für Sichtbarkeit, Leadgenerierung und Marketing-Performance abzuleiten.
Fazit: KI-Traffic richtig verstehen, statt nur Besucher zu zählen
KI verändert nicht nur, wie Menschen Anbieter, Produkte und Lösungen finden. Auch die Art, wie Websites technisch aufgerufen und Informationen verarbeitet werden, verändert sich. Das macht klassische Analytics-Daten nicht wertlos – aber die Unterscheidung verschiedener Zugriffsarten wichtiger.
Welche Zugriffe stammen von echten Menschen? Welche von KI-Crawlern? Welche Inhalte sind technisch erreichbar? Und welche Besucher werden tatsächlich zu qualifizierten Leads?
Unser Rat: Starten Sie mit Ihren vorhandenen Daten. Messen Sie erkennbare KI-Weiterleitungen, prüfen Sie die Crawler-Zugriffe in den Server-Logs und verbinden Sie diese Erkenntnisse mit Ihren Marketingzielen. So wird aus einem abstrakten KI-Trend eine konkrete, handhabbare Aufgabe.
Wenn Sie Unterstützung bei Analyse, Tracking und Einordnung benötigen: Lassen Sie uns Ihre Daten gemeinsam ansehen.
Häufig gestellte Fragen
Teilweise. GA4 kann Weiterleitungen aus KI-Anwendungen wie ChatGPT oder Perplexity erfassen, wenn eine Herkunftsinformation übermittelt wird. Bekannter Bot-Traffic wird automatisch ausgeschlossen. Für die Analyse von KI-Crawlern benötigen Sie ergänzende Datenquellen, etwa Server-Logs.
OpenAI verwendet unter anderem OAI-SearchBot, GPTBot und ChatGPT-User. Diese Kennungen stehen für unterschiedliche Zwecke. Sie können in HTTP-Zugriffsprotokollen danach suchen und die Identität soweit möglich anhand der von OpenAI veröffentlichten IP-Bereiche prüfen.
Sie können Zugriffe bekannter Google-Crawler erkennen. Daraus folgt nicht zuverlässig, ob Inhalte für eine konkrete Gemini-Antwort verwendet wurden. Google-Extended ist ein Token für robots.txt und kein eigener HTTP-User-Agent.
Nicht zwangsläufig. Ein Request zeigt zunächst, dass ein System Inhalte abgerufen hat. Ob diese später zitiert oder empfohlen werden, lässt sich daraus nicht unmittelbar ableiten. Dafür braucht es eine separate Analyse der KI-Sichtbarkeit.
Das hängt von Ihrer Strategie ab. Für eine Auffindbarkeit in KI-Suchfunktionen kann es sinnvoll sein, relevante Suchcrawler zuzulassen. Bei Training-Crawlern können andere Regeln gelten. Eine robots.txt ist außerdem keine technische Zugriffssperre.
Für viele mittelständische Websites ist zunächst ein monatlicher Check ausreichend. Bei hohem Aufkommen oder technischen Auffälligkeiten kann ein häufigeres Monitoring sinnvoll sein. Entscheidend ist die Ableitung konkreter Maßnahmen.